

“覆水难收”:当人工智能遇上政治
人工智能生成的内容与真实内容已越来越难以辨别。随着今年多场重要选举的举行,各方需采取更多措施来打击人工智能的滥用。
本文由 AI 翻译,关键事实请以原文为准。
今年1月,一通使用美国总统Joe Biden声音的机器人电话,告诉新罕布什尔州居民为年底的总统选举“保留选票”。这通电话暗示居民只能在初选或总统选举中择一投票,但实际上两者皆可投票。
事后披露,这通机器人电话是政治顾问Steve Kramer在为竞争对手候选人工作时,花费500美元委托制作的。他声称此举是为了提高人们对人工智能(AI)在政治领域所带来危险的认识。美国政府此后已禁止使用人工智能生成声音的机器人电话。
如今,要分辨出人工智能生成内容的蛛丝马迹已变得困难得多,这类技术可能以前所未有的方式误导和剥夺选民的投票权。
今年的选举数量创下历史新高,各国政府比以往任何时候都更需要正视这个问题,否则将面临严重后果。
日益加剧的危险
新加坡管理大学法律系副教授Eugene Tan表示,当人们谈论剥夺选民投票权时,通常想到的是选民无法行使其投票权,或因居住地离投票站太远而无法投票的情况。
他表示:“(在这种情况下),我们所说的剥夺投票权,是指选民因受到人工智能操纵而实际上被剥夺了选择权。”他补充说,这类行为有可能损害民主进程。
新加坡国立大学(国大)的Hahn Jungpil教授表示,与过去的其他技术发展一样,人工智能是一把双刃剑,既能用于行善,也能用于作恶。
虽然人工智能可以普及计算机生成图像在教育领域的应用,但它也降低了制造令人信服的虚假信息的门槛。
人工智能自诞生以来已取得长足发展。虽然大多数人至少都听说过ChatGPT——其在2022年11月推出时,成为了人工智能应用的一个分水岭——但在此之前,已有许多类似的技术在酝酿之中,只是当时它们还不够成熟,未能进入主流。
例如,在那一年的9月,Meta(前身为Facebook)发布了一个名为Make-A-Video的新人工智能系统。顾名思义,它能通过技术提示生成视频。
但其视频质量却差强人意。在一个年轻情侣雨中漫步的视频中,两人的肩膀粘在一起,并以一种令人不安的方式扭曲变形,他们手中的白色塑料伞也像宣纸一样摇晃。当然,从那时起情况已发生了巨大变化——如今,普通观察者可能已无法分清哪些是真实的,哪些是人工智能生成的。
2022年9月由Meta的Make-A-Video人工智能系统生成的视频。
2024年2月由OpenAI的文本转视频模型Sora生成的视频。
这种情况当然不限于政治领域。今年1月,一家跨国公司的香港员工遭遇诈骗,导致公司损失了2亿港元(约合3400万新元)。
在其中一起事件中,一名员工被邀请参加一个群组视频会议,并被要求向诈骗者转账。通话中的每个人,包括身在英国的首席财务官,都是通过深度伪造技术数字合成的。
Hahn教授说:“在生成式人工智能出现之前,使用视频编辑技术制作深度伪造内容可能要困难得多,成本也更高。”
“现在,这项技术已经发展到可以更低成本地大量制作(它们),并能创建定制化、高度个性化的深度伪造内容版本。”
安永咨询(Ernst & Young Advisory)的咨询合伙人Ritin Mathur指出,这对试图管理人工智能危害的监管机构来说是一个挑战。
他表示:“难题在于,如何在技术的创新潜力和有益方面与风险方面之间取得平衡?”
以技术对抗技术
如果危害是明确的,但传播媒介已经改变,那么法规该如何跟上?又该由谁来承担责任?
在某些情况下,一些公司已主动采取保护措施,以防止其软件被用于不法目的。
例如,Adobe Photoshop在其防伪系统中,禁止客户打开精细的纸币图像。
同样,运营生成式人工智能服务的公司也试图阻止其技术在特定情况下被滥用。
2022年11月,人工智能初创公司Stability AI更新了其图像生成器Stable Diffusion,削弱了其生成不适宜工作场所(NSFW)内容以及模仿特定艺术家风格图片的能力。
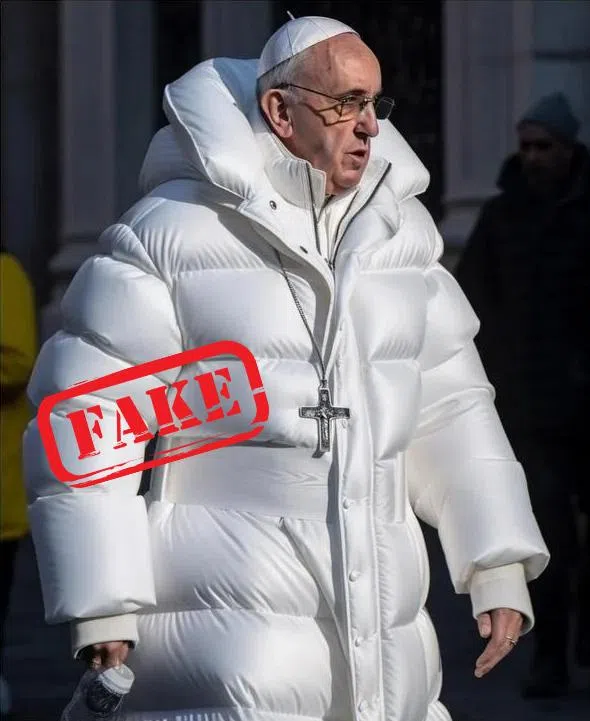
然而,这些人工智能模型是“黑箱”,这意味着人们不总能理解它们的工作原理,也无法阻止它们出故障。用户仍然可以通过修改提示词来诱骗生成器产出特定内容。
今年1月,微软Designer人工智能图像生成器的一些用户绕过了软件的保护措施,制作了Taylor Swift等名人的露骨色情图片。
在17小时内,其中一张Swift的照片在该网站上获得了超过4500万次浏览。发布该照片的账户被暂停使用,而这个漏洞在几天后才被修复。
新加坡社科大学法学讲师Ben Chester Cheong表示,人工智能算法的不透明性使其工作原理难以被理解。
他说:“这种‘黑箱’效应阻碍了确保公平和问责的努力,为潜在的歧视和意外后果留下了空间。”
国大的Hahn教授指出,为了打击人工智能生成的虚假信息,研究人员正积极研发水印技术。
这类技术可用于在人工智能生成的内容中添加隐形水印,而这些水印可以被特殊软件“看到”。
尽管如此,他表示,通过立法来强制实施这种方法可能效果不佳,因为存在一些个人可以独立运行的开源人工智能模型。通过修改源代码,个人可以阻止其内容被添加水印。
他补充道:“追究公司的责任比追究每个个人的责任要容易得多,但由于已经存在大量开源软件……可以说是覆水难收了。”
在某些司法管辖区,已经有法律来处理网络假信息或“假新闻”。
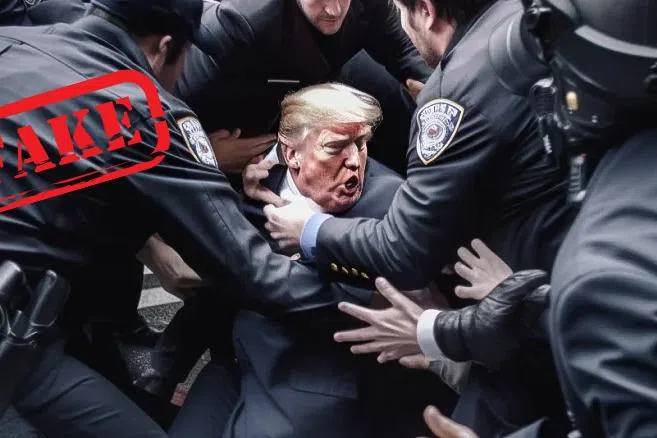
2018年,法国授权法官在选举期间下令立即删除网络假信息,这被认为是欧洲首次尝试解决该问题。批评者认为,该法律可能被用来审查新闻媒体。
韩国在2021年也曾试图通过一项法案来处理网络假信息。该法案要求包括互联网新闻服务提供商在内的媒体机构,对错误报道发布更正声明,并提高法院可就发布虚假或捏造报道判处的罚款金额。
然而,由于批评者称该法律可能被用来压制媒体的批判性报道,该法案最终搁浅。
新加坡管理大学的Tan教授认为,责任应在于社交媒体平台,它们应负责检测和删除有害的深度伪造内容。
他说:“我认为它们确实是起点,因为它们是这些虚假信息传播的最终载体。”
他认为,由于虚假信息的制造速度超过了政府的检测速度,因此应要求社交媒体平台及时过滤此类内容。
尽管如此,他指出,检测人工智能生成的虚假信息将使这些公司耗费额外资源。
他说:“他们会认为‘如果别人都不做,我们为什么要这么做?’”
Hahn教授指出,应对深度伪造的另一种方法是,使用深度学习模型主动分析和检测用户在社交媒体上遇到虚假信息时的行为模式。
他说:“我们可以找到行为线索,从而推断出这是虚假内容。这并不需要有人明确举报或说:‘哦,这可能是假的’。”他补充说,这可能是一个比为所有人工智能生成内容添加水印更容易的解决方案。
如何立法
在3月份通讯及新闻部的供应委员会辩论中,部长Josephine Teo表示,政府对人工智能生成的内容采取强硬立场。
她说:“因此,针对这些内容进行迅速处理的专项立法是这一基础设施的支柱之一。”
“这包括《防止网络假信息和网络操纵法令》(POFMA),该法令使我们能够发布更正声明,并用正确事实标注人工智能生成的虚假信息。如果内容对公共利益构成严重危害,我们也可以考虑发出禁令。”
Tan教授表示,虽然《防止网络假信息和网络操纵法令》有助于打击人工智能生成的虚假信息,但如果内容在网上传播哪怕只有一天,损害就可能已经造成。他补充说,目前的法律尚不足够。
他指出:“我们总是在追赶。”
但从更积极的方面来看,Bain & Company合伙人Mohan Jayaraman表示,尽管新加坡是一个小司法管辖区,但它在技术问题上采取了非常前瞻的观点。
为了平衡人工智能的利弊,国家还与企业密切合作,共同制定人工智能治理框架。
其中一个例子就是由新加坡金融管理局与其他监管机构(如个人数据保护委员会)以及金融机构合作制定的公平、道德、问责、透明(FEAT)原则。
公平原则确保社会中的某些群体或个人不会因人工智能和数据分析驱动的决策而系统性地处于不利地位,除非这些决策有正当理由。
Mohan说:“这不仅仅是监管。它还作为一套工具被整合起来,提供给人们以支持他们管理监管。”
“我认为新加坡已经找到了非常好的方法,在控制风险的同时,也与行业参与保持一致。”
Covenant Chambers律师事务所董事Khelvin Xu表示,一种立法方式可以是借鉴欧盟等机构的指导,欧盟目前正在制定一项《人工智能法案》。
他表示:“这样做的好处在于……它很可能使新加坡的做法与其他司法管辖区采取的做法更加协调统一。”他补充说,如果人工智能工具能够在本地和其他地区无缝使用,新加坡将从中受益。
公众教育
Hahn教授指出,尽管对人工智能生成的虚假信息进行立法很重要,但技术也可以用来识别公众可以信赖的人类生成内容的来源。
他说:“我们不是试图检测什么是人工智能生成的,而是试图证明什么是人类生成的。任何未经人类署名的内容,就可被认为是人工智能生成的,所以使用者需自行当心。”
他补充说,在没有必要工具帮助用户识别真伪内容的情况下,将识别此类信息的负担完全推给消费者是不负责任的。
“我们确实需要教育(用户),但也要让他们更容易地运用这些知识。”
私营领域的媒体机构和科技公司已在“内容来源和真实性联盟”(Coalition for Content Provenance and Authenticity)等开放技术标准方面进行合作,以验证发布的内容。
这些标准将提供方法,为内容添加标签,标明其创建者、创建或编辑的方式、时间及地点等信息。这些细节可以向用户展示,以验证他们所看到的内容确实是人类生成的。
该联盟的成员公司包括Adobe、BBC和公关公司Publicis Groupe。
资讯通信媒体发展局也于去年6月成立了AI Verify基金会,旨在开发用于负责任地使用人工智能的测试工具。
新加坡管理大学的Tan教授表示,虽然企业和公民都将扮演各自的角色,但政治人物也必须随时准备否认深度伪造内容,即使这些内容可能对他们有利。
他补充说,这一点尤为重要,因为新加坡必须在2025年11月之前举行大选。一旦宣布选举,就很难期望理性成为选民的主导心态。
“我们必须记住,归根结底,对选举诚信构成最严重威胁的,或许正是政治人物和政党本身。
他说:“不能因为某个深度伪造内容削弱了你的政治对手、对你有利,你就对此保持沉默。”






